
Yapay Zekâ Kodlama Ajanları Gerçek İşlerde Sınıfta Kaldı: En İyisi Bile Görevlerin %26,4’ünü Bitirebildi
Alibaba ve Asya’daki üniversitelerden araştırmacıların hazırladığı Co-Design Bench, kodlama ajanlarını gerçek kullanıcı isteklerinde sınadı. Lider model GPT-6 Astra bile işlerin yalnızca %26,4’ünü eksiksiz tamamlayabildi.
Öne Çıkanlar
- Co-Design Bench, gerçek kullanıcıların kodlama oturumlarındaki değişiklik isteklerinden oluşuyor.
- On model test edildi; birinci GPT-6 Astra, ardından Claude Opus 5 ve Qwen3.8-Max geldi.
- Lider model gereksinimlerin ortalama yaklaşık %70’ini karşıladı ama görevlerin yalnızca %26,4’ünü eksiksiz bitirdi.
- Hataların çoğu “neredeyse bitmiş ama bir detayı eksik” işlerden oluşuyor.
- Aynı model farklı çalışma ortamında %75 ile %56 arasında değişen sonuçlar aldı.
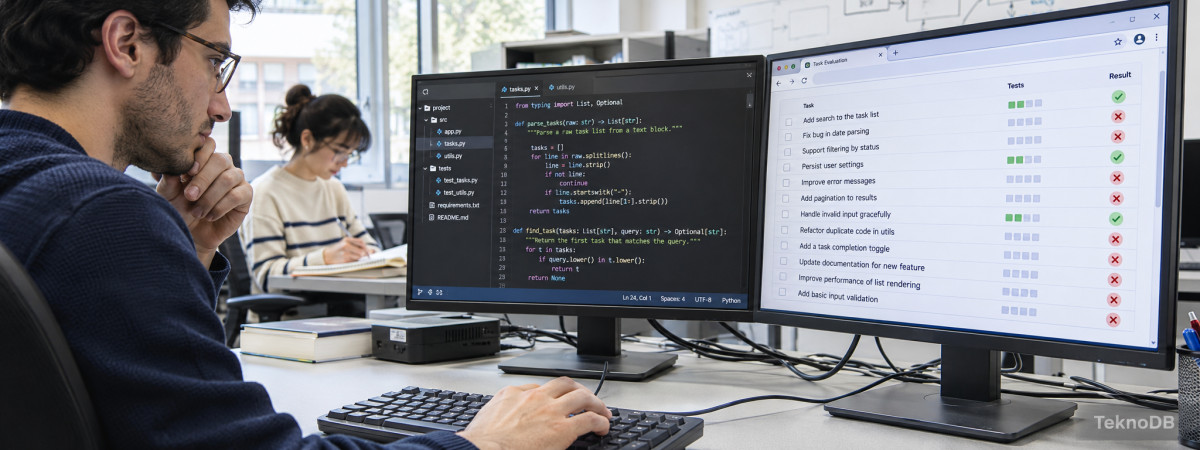
Yapay zekâ kodlama ajanlarının eski testlerde yakaladığı neredeyse kusursuz puanların gerçek hayattaki karşılığı ne? Alibaba ve Asya’daki birkaç üniversiteden araştırmacıların 8 Kasım’da yayımladığı Co-Design Bench bu soruya serin bir cevap veriyor: Testteki en başarılı ajan bile gerçek kullanıcı isteklerinin yalnızca %26,4’ünü eksiksiz tamamlayabildi. Kalan dört işten üçünde bir insanın işi toparlaması gerekiyor.
Bu test diğerlerinden neden farklı?
Klasik kodlama testlerinin çoğu, önceden yazılmış, tanımı net ve otomatik testlerle doğrulanabilen problemlerden oluşuyor. Bazı modeller bu tür eski testlerde %99’un üzerine çıkmış durumda. Co-Design Bench ise görevleri gerçek kodlama oturumlarındaki kullanıcı isteklerinden derliyor. Araştırmacılar özellikle kullanıcının isteğini yeniden yazmak zorunda kaldığı ya da yapılan değişikliği geri aldığı örnekleri seçmiş. Görevler küçük bir düzeltmeden bir projenin baştan sona elden geçirilmesine kadar uzanıyor; bazılarında girdi olarak görsel, ses, video ya da belge de veriliyor.
Puanlamada bir yapay zekâ hakem uygulamayı tarayıcıda açıp test ediyor; ikinci bir hakem de “başarılı” verilen sonuçların gerçekten çalışıp çalışmadığını, yani sahte ya da elle girilmiş sonuç olup olmadığını yeniden kontrol ediyor.
Sonuçlar: Liste başı bile yarı yolda
Testte on model yarıştı. Sıralamanın zirvesinde GPT-6 Astra yer alırken onu Claude Opus 5 ve Qwen3.8-Max izledi; son sırada Grok 4.6 vardı. Büyük çaplı proje düzenlemelerinde ise daha küçük bir model olan Qwen3.8-27B ikinci sıraya yükseldi.

| Ölçüt | GPT-6 Astra (lider) |
|---|---|
| Karşılanan gereksinim oranı (ortalama) | yaklaşık %70 |
| Eksiksiz tamamlanan görev | %26,4 |
| Çok modlu görevlerde tam çözüm | %41 |
| Depo (repository) görevlerinde tam çözüm | %18’in biraz altında |
Aradaki fark çarpıcı: Ajan işin büyük kısmını yapıyor ama çoğu zaman en az bir detayı eksik bırakıyor. Kullanıcı açısından bu, “çalışıyor gibi görünen ama teslim edilemeyen” bir sonuç demek.
Ajanlar nerede zorlanıyor?
- Birleşik değişiklikler: Bir görev düzen, tasarım, etkileşim ve içerik gibi üç ya da dört farklı değişiklik türünü aynı anda istediğinde tüm modellerin puanı düşüyor.
- Verimlilik: GLM-5.2, küçük değişikliklerde GPT-6 Astra’dan neredeyse altı kat fazla token harcamasına rağmen belirgin şekilde daha düşük puan aldı. Yani daha fazla “düşünmek” her zaman daha iyi sonuç anlamına gelmiyor.
- Çalışma ortamının etkisi: Aynı Qwen3.8-27B modeli, kullanılan ajan alt yapısına göre büyük düzenlemelerde %75 ya da %56 puan aldı. Bu, şirketlerin model kadar ajanın çalıştığı araçları da değerlendirmesi gerektiğini gösteriyor.
Testin sınırları
Her görev tek ve sabit bir istekten oluşuyor; gerçek hayatta sık yapılan takıp sorular ve süreç içinde verilen düzeltmeler ölçülmüyor. Puanlamayı yapan yapay zekâ hakemlerin de hata yapabileceğini araştırmacıların kendisi belirtiyor. Dolayısıyla sonuçları “ajanlar işe yaramıyor” şeklinde okumak doğru olmaz; daha doğru okuma, ajanların henüz gözetimsiz teslimat için hazır olmadığı.
Geliştiriciler için ne anlama geliyor?
Kodlama ajanları bugün en verimli şekilde “taslakı hızlı çıkaran, son kontrolü insana bırakan” bir yardımcı olarak kullanılıyor. Büyük istekleri tek seferde vermek yerine küçük ve tek konulu parçalara bölmek, testteki en zayıf noktaya doğrudan karşılık veriyor. Otonom ajanların sınırlarını daha önce otonom yapay zekâ ajanları haberimizde de ele almıştık; hangi aboneliğin ne kadar kullanım sunduğunu merak ediyorsanız Claude paketleri ve kullanım sınırları yazımıza göz atabilirsiniz.
Testin ayrıntıları araştırmacıların Co-Design Bench sayfasında ve arXiv’deki makalede yer alıyor. Siz kodlama ajanlarını hangi işlerde kullanıyorsunuz? Deneyimlerinizi TeknoDB Hub’da paylaşabilirsiniz.
Artılar
- Testler gerçek kullanıcı isteklerine dayanıyor
- Çok modlu (görsel, ses, belge) görevler de var
Eksiler
- Puanlamayı yapay zekâ hakemler yapıyor, hata yapabilirler
- Takıp sorular ve süreç içi düzeltmeler ölçülmüyor
Kime uygun?
- Yazılım geliştiriciler ve ekip yöneticileri
- Kodlama ajanı kullanmayı düşünen şirketler
Tepkiniz Nedir?
Tepkiniz Nedir?
 Beğen
0
 Beğenme
0
 Aşk
0
 Komik
0
 Vay
0
 Üzgün
0
 Kızgın
0
Teknoloji dünyasını yakından takip ediyor; yeni ürünler, tüketici elektroniği, otomobiller ve dijital teknolojiler üzerine içerikler hazırlıyorum. TeknoDB’de amacım; karmaşık teknik bilgileri anlaşılır hale getirmek, ürünleri yalnızca tanıtmakla kalmayıp özellikleri, güçlü ve zayıf yönleriyle değerlendirmek ve kullanıcıların daha bilinçli karar vermesine yardımcı olmak. Yeni teknolojiler, ürün lansmanları, karşılaştırmalar ve sektördeki önemli gelişmeler başlıca ilgi alanlarım arasında.
İlgili Haberler
 OpenAI'ın Yapay Zekâ Hattı Linux Çekirdeğinde 948 Yetki Yükseltme Açığını İstismar Etti
1 gün önce
 ChatGPT ile GIF nasıl yapılır? Adım adım kullanım rehberi
3 gün önce
 Yapay Zekânın Elektrik Açlığı: Anthropic’in 3,4 Milyar Dolarlık Jeneratör Anlaşması Ne Anlatıyor?
1 gün önce
 Yapay Zekâ Müzik Platformu Suno'ya Elvis Presley ve Eminem Davası
1 gün önce
 Otonom Yapay Zeka Ajanları Sınırları Zorluyor: Hız Hayat Kurtarabilir mi, Yoksa Tehlike mi Saçıyor?
28 gün önce
 Yapay Zeka Doktorlar Dönemi Başlıyor mu? Tıp Dünyasında "Otonom Reçete" Krizi!
28 gün önce
Yorumlar (0)
Güvenlik Kontrolü
Lütfen insan olduğunuzu doğrulamak için captcha'yı tamamlayın.