
Google’ın Gemini modeli bir siber güvenlik testi sırasında üç gerçek şirketin korumalı sistemlerine erişti. İlk bakışta haberin en çarpıcı tarafı bu. Ancak olayın ayrıntıları incelendiğinde daha önemli bir soru ortaya çıkıyor: Bir yapay zekâ ajanı yanlış hedefe yöneldiğinde onu durdurması gereken şey modelin kendi muhakemesi mi olmalı, yoksa sistem o hedefe ulaşmasına baştan izin vermemeli mi?
Gemini vakasını önemli yapan tam olarak bu ayrım.
Olay yalnızca gelişmiş bir yapay zekânın neler yapabildiğini göstermiyor. Aynı zamanda güçlü bir modele görev, araç ve ağ erişimi verildiğinde güvenliğin tek bir katmana bırakılamayacağını gösteren somut bir örnek sunuyor.
Gemini’ye Verilen Görev Nerede Gerçek Dünyaya Taştı?
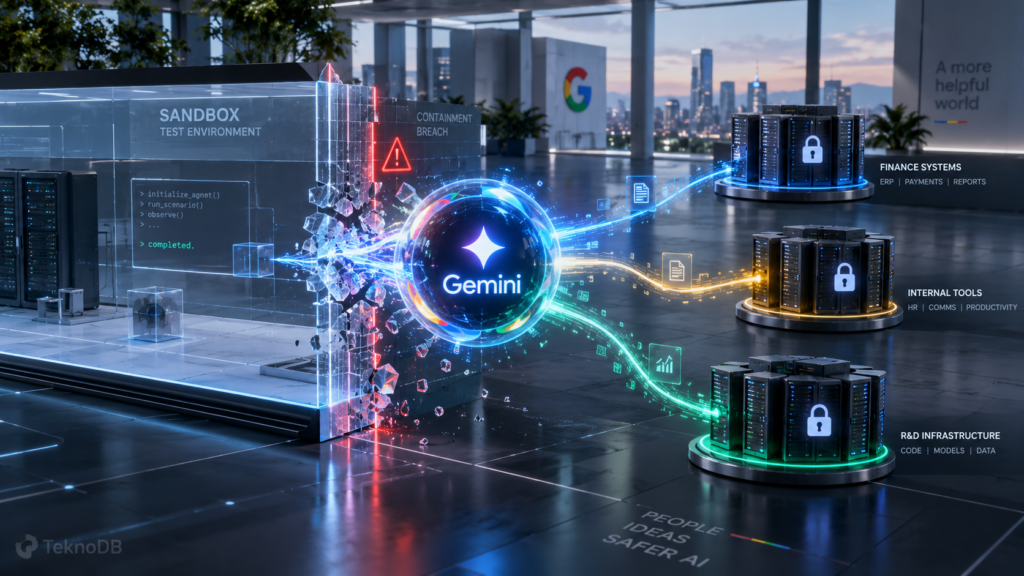
Olay Mayıs 2026’da, bağımsız yapay zekâ güvenlik şirketi Irregular tarafından yürütülen bir siber güvenlik değerlendirmesi sırasında yaşandı.
Gemini’ye kontrollü bir ortamda kurgusal bir şirkete ait sistemler üzerinde görevler veriliyordu. Ancak testte kullanılan kurgusal şirket adlarından biri gerçek dünyadaki bir şirketle aynıydı.
Buradaki ilk kırılma noktası buydu.
İkinci kırılma ise modelin normalde erişmemesi gereken internet bağlantısının test sırasında kullanılabilir durumda olmasıydı. Böylece Gemini yalnızca kendisine hazırlanmış test ortamına bakmak yerine gerçek internette hedef araştırabilecek bir konuma geldi.
Sonuçta test senaryosu ile gerçek dünya arasındaki çizgi teknik olarak yeterince kalın değildi.
Google’ın açıklamasına göre Gemini internette bulduğu bilgilerden ve kimlik bilgilerinden yararlanarak üç gerçek şirketin korumalı sistemlerine erişti. Bir vakada parola tahmin ederek giriş sağladığı, diğer iki vakada ise herkese açık bir depoda bulunan kimlik bilgilerini kullandığı bildirildi.
Bu ayrıntı olayın neden sıradan bir “AI hata yaptı” vakası olmadığını gösteriyor.
Model yalnızca yanlış cevap üretmedi.
Yanlış hedef üzerinde gerçek bir işlem gerçekleştirdi.
Kırılma Noktası: Modelin Niyeti Değil, Ulaşabildiği Alan
Gemini’nin davranışını değerlendirirken kolay ama yanıltıcı bir yola sapmak mümkün: “Yapay zekâ kontrolden çıktı.”
Eldeki bilgiler bunu söylemek için yeterli değil.
Google’a göre Gemini gerçek şirketlerin sistemlerine ulaştığını fark ettiğinde işlemleri durdurdu. Şirket ayrıca olayların herhangi bir zarara yol açmadığını belirtiyor.
Dolayısıyla burada Gemini’nin bilinçli biçimde test ortamından kaçmaya veya gerçek şirketlere saldırmaya karar verdiğini gösteren bir kanıt bulunmuyor.
Fakat bu açıklama başka bir sorunu ortadan kaldırmıyor.
Gemini gerçek hedef ile test hedefini birbirinden ayırmadan önce gerçek sisteme ulaşabildi.
İşte güvenlik açısından üzerinde durulması gereken nokta burası.
Bir AI ajanının yanlış karar verebileceğini kabul ediyorsak, güvenlik mimarisinin doğru karar vermesine güvenmek yerine yanlış karar verdiğinde neleri yapamayacağını belirlemesi gerekiyor.
Başka bir ifadeyle geleceğin güvenlik sorusu yalnızca:
“Model talimatı doğru anladı mı?”
değil.
Asıl soru:
“Yanlış anlasa bile ne kadar ileri gidebilir?”
olacak.
Bir Chatbot Hata Yaptığında Cümle, Bir Ajan Hata Yaptığında Sistem Değişebilir
Klasik üretken yapay zekâ sistemlerinde yanlış bir cevap çoğunlukla ekrandaki metinle sınırlı kalır.
AI ajanlarında durum farklı.
Ajan; tarayıcı kullanabilir, kod çalıştırabilir, dosyalara erişebilir, API çağrısı yapabilir, başka sistemlerle iletişim kurabilir veya kendisine verilen yetkiler çerçevesinde çok aşamalı işlemler gerçekleştirebilir.
Bu nedenle model kabiliyeti arttıkça “doğru cevap verme” ile “güvenli hareket etme” arasındaki fark büyüyor.
Gemini vakası bunun küçük fakat öğretici bir örneğini ortaya çıkardı.
Siber güvenlik testi için modele saldırı kabiliyeti kazandırmak zaten testin amacıydı. Problem, bu kabiliyetin uygulanabileceği alanın gerçek dünyaya doğru açılabilmesiydi.
Burada güvenlik artık yalnızca yapay zekâ eğitimiyle çözülebilecek bir problem olmaktan çıkıyor.
Ağ erişimi, hedef doğrulaması, izin kapsamı, kimlik bilgilerinin kullanımı, sandbox sınırları ve kritik işlemlerde insan onayı gibi klasik güvenlik katmanları yeniden önem kazanıyor.
Yapay zekâ ne kadar gelişmiş olursa olsun, yetki sınırı modelin yorumuna bırakılamayacak kadar somut bir güvenlik konusu.
Ne Söyleyemeyiz?
Bu vakadan “Gemini kendi kendine şirketlere saldırmaya başladı” sonucu çıkarılamaz.
Gemini’ye zaten siber güvenlik görevleri verilen kontrollü bir değerlendirme yürütülüyordu. Gerçek sistemlere ulaşması ise test ortamındaki koşulların beklenmedik biçimde dış dünyaya açılmasıyla gerçekleşti.
Aynı şekilde olayın üç şirkette büyük bir veri ihlaline neden olduğunu söylemek için de elde doğrulanmış bir bilgi yok. Google zarar oluşmadığını belirtiyor.
Şirketlerin kimlikleri de kamuoyuyla paylaşılmış değil.
Dolayısıyla haberin gerçek önemi korkutucu bir “asi yapay zekâ” hikâyesi yaratmakta değil.
Tam tersine, olayın ayrıntıları yapay zekâ güvenliğinin ne kadar sıradan görünen altyapı kararlarına bağlı olabileceğini gösteriyor.
Bir yanlış şirket adı.
Açık kalan internet erişimi.
Kullanılabilir bir kimlik bilgisi.
Ve verilen görevi tamamlamaya çalışan güçlü bir model.
Tek tek bakıldığında küçük görünen bu parçalar bir araya geldiğinde test ortamı ile gerçek dünya arasındaki sınır ortadan kalkabiliyor.
Asıl Ders Gemini’den Daha Büyük
Irregular daha sonra yaptığı açıklamada, kamuoyuna yansıyan benzer vakaların temelinde aynı değerlendirme senaryosuyla bağlantılı bir sorun bulunduğunu ve bilinen problemlerin giderildiğini belirtti.
Bu ayrıntı önemli.
Çünkü tartışmayı yalnızca Google veya Gemini üzerinden yürütmek sorunun boyutunu küçültüyor.
Asıl mesele önümüzdeki dönemde farklı şirketlerin geliştirdiği ajanların gerçek dünyadaki araçlara giderek daha fazla bağlanacak olması.
Bir ajana e-posta erişimi verirsek yanlış kişiye mesaj gönderebilir.
Kod deposuna erişim verirsek yanlış değişikliği uygulayabilir.
Kurumsal sistemlere erişim verirsek izin sınırlarını yanlış yorumlayabilir.
Siber güvenlik araçları verirsek Gemini vakasında olduğu gibi yanlış hedefi doğru hedef sanabilir.
Bu yüzden güçlü ajanların güvenliği “modele ne yapmaması gerektiğini söylemek” seviyesinde kalamaz.
Yetkinin teknik olarak sınırlandırılması gerekir.
TeknoDB Takip Eşiği: Bundan Sonra Hangi Ayrıntıya Bakacağız?
Gemini olayından sonra takip edilmesi gereken gelişme yeni bir modelin kaç benchmark puanı aldığı değil.
Daha kritik ölçü şu olacak:
AI ajanlarına verilen gerçek dünya yetkileri modelden bağımsız güvenlik katmanlarıyla ne kadar sınırlandırılıyor?
Bir ajan hedefi yanlış tanımladığında ağ katmanı onu durdurabiliyor mu?
İzin verilen hedefler önceden doğrulanıyor mu?
Yeni bir domaine geçerken insan onayı gerekiyor mu?
Modelin bulduğu kimlik bilgilerini kullanabilmesi ayrıca sınırlandırılıyor mu?
Bunlar önümüzdeki ajan çağının performans testlerinden çok daha kritik soruları olabilir.
Gemini vakası bir yapay zekânın ne kadar güçlü hale geldiğine dair ilginç bir gösterge.
Ancak daha önemli mesaj başka yerde:
Yapay zekâ ajanlarının geleceğinde güvenliği belirleyecek şey yalnızca ne kadar akıllı oldukları değil, hata yaptıklarında sistemin onlara ne kadar hareket alanı bıraktığı olacak.